Meu Switch reiniciou? Spoiler: NÃO reiniciou.
Trabalhando com consultoria já vimos diversos cenários e os desafios sempre inovadores, sempre tentamos entregar um projeto que esteja alinhado com o desejo do cliente, e para isso criamos soluções que nem mesmo o cliente sabia que necessitava. Parte dessa solução não é técnica, mas sim de visão de negócio, enxergar além da tela do computador. Entender que cada cliente possui um cenário totalmente diferente do outro é a chave do sucesso.
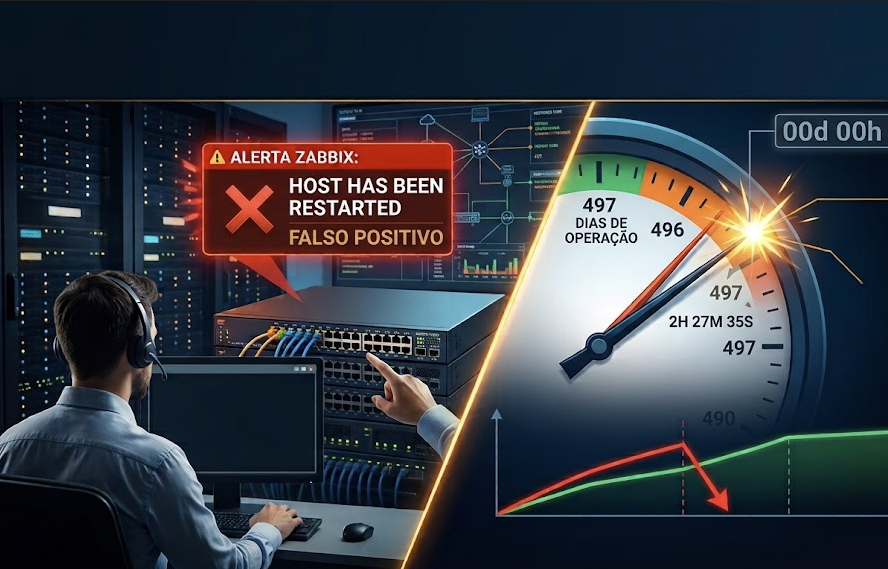
Recentemente em um cliente, era uma quinta-feira tranquila quando o Zabbix disparou um alerta: HOST HAS BEEN RESTARTED no switch core da rede do cliente. O time de infraestrutura foi checar. O switch estava operando normalmente. Uptime de 71 semanas no show system. Nenhum log de reinicialização. Nenhum evento no histórico.
Nada.
Então de onde veio o alarme?
A resposta está em um detalhe sutil do protocolo SNMP que passa despercebido até que o contador estoura — literalmente.
O que o Zabbix estava monitorando?
O item “Host has been restarted” no Zabbix coleta o OID hrSystemUptime, da HOST-RESOURCES-MIB:
OID: 1.3.6.1.2.1.25.1.1.0
Esse OID representa o tempo decorrido desde o último boot do equipamento, expresso em centissegundos (centésimos de segundo). Parece simples, mas tem um detalhe importante: ele é armazenado como um inteiro sem sinal de 32 bits — o tipo TimeTicks do SNMP.
Quando olhei o último registro do Zabbix de uptime o valor era: 497 dias, 2 horas, 27 minutos e 35 segundos
E todo inteiro de 32 bits tem um limite.
O limite matemático que ninguém lembra
Um inteiro de 32 bits sem sinal suporta valores de 0 a 4.294.967.295. Convertendo para tempo:
4.294.967.295 centissegundos ÷ 100 → 42.949.672 segundos ÷ 60 → 715.827 minutos ÷ 60 → 11.930 horas ÷ 24 → 497 dias, 2 horas, 27 minutos e 35 segundosDepois desse período, o contador estoura e volta a zero automaticamente. Esse comportamento se chama wraparound (ou counter rollover) e é definido pelo próprio protocolo SNMP — não é um bug do equipamento, não é falha de configuração. É matemática.
O Zabbix viu o hrSystemUptime ir de um valor alto para zero e interpretou como reinicialização. O switch estava em operação contínua há 497 dias — exatamente no limite do contador.
Mas e o “Network Uptime”? Por que ele não disparou?
O Zabbix também monitora o sysUpTime, da SNMPv2-MIB:
OID: 1.3.6.1.2.1.1.3.0Esse OID mede o tempo desde a última reinicialização do agente SNMP — não do hardware. Também é TimeTicks de 32 bits, portanto matematicamente sujeito ao mesmo wraparound. Mas os dois contadores são independentes.
O agente SNMP pode ter sido reiniciado em algum momento anterior (uma atualização de firmware, um reload de processo), fazendo com que seu contador estivesse em uma fase diferente. Os dois raramente chegam ao limite no mesmo instante — e foi exatamente isso que salvou a situação.
| Característica | hrSystemUptime | sysUpTime |
|---|---|---|
| MIB | HOST-RESOURCES-MIB | SNMPv2-MIB |
| Mede | Tempo desde o boot do hardware/OS | Tempo desde o início do agente SNMP |
| Reage a boot do equipamento | Sim | Sim |
| Reage a restart do agente | Não | Sim |
| Sujeito ao wraparound | Sim (497 dias) | Sim (497 dias) |
| Uso recomendado | Informativo / dashboard | Referência primária de disponibilidade |
O sysUpTime é o campo definido pelo RFC 1213 como referência de tempo de operação do dispositivo gerenciado. Ferramentas de monitoramento, fabricantes e documentações técnicas utilizam sysUpTime como métrica canônica de disponibilidade — e por um bom motivo: o agente SNMP reinicia com o hardware, mas também reinicia em eventos menores, fazendo com que raramente chegue aos 497 dias sem um motivo legítimo.
Corrigindo a trigger no Zabbix
O template Dell Force S-Series by SNMP (e muitos outros de equipamentos de rede) tem a trigger “Host has been restarted” com esta expressão:
(last(hrSystemUptime) > 0 AND last(hrSystemUptime) < 10m)
OR
(last(hrSystemUptime) = 0 AND last(sysUpTime) < 10m)
O problema está na primeira condição: ela dispara quando o hrSystemUptime está entre 0 e 10 minutos, sem validar o sysUpTime. Após o wraparound, o contador recomeça de 1 — e a condição é verdadeira pelos próximos 10 minutos, gerando o falso positivo.
A correção é simples: exigir que ambos os contadores indiquem reinicialização recente:
(last(hrSystemUptime) > 0 AND last(hrSystemUptime) < 10m AND last(sysUpTime) < 10m)
OR
(last(hrSystemUptime) = 0 AND last(sysUpTime) < 10m)
Com essa lógica, um wraparound isolado do hrSystemUptime mantém o sysUpTime inalterado (valor alto), a condição falha e o falso positivo é suprimido. A alteração feita diretamente no template propaga a correção automaticamente para todos os hosts que o utilizam.
Resumindo
Se você monitora switches, roteadores ou qualquer equipamento de rede via SNMP no Zabbix, vale revisar suas triggers de uptime. O wraparound não avisa quando vai chegar, ele só estoura e a depender do ambiente você terá uma enxurrada de eventos falso positivos.
Para lembrar:
- O OID hrSystemUptime é um contador de 32 bits — ele estoura depois de 497 dias, 2 horas e 27 minutos de operação contínua.
- Quando estoura, o Zabbix interpreta o retorno ao zero como reinicialização do equipamento.
- A solução não é parar de monitorar o hrSystemUptime, mas cruzar com o
sysUpTimeantes de disparar o alerta. - Equipamentos com alta disponibilidade e longos períodos de uptime são os mais suscetíveis — exatamente os que você menos quer ignorar por causa de um falso alarme.
Você já teve um falso alarme parecido no seu ambiente? Me conta aqui nos comentários.
About author

Você pode gostar também
A lenda do arquivo perdido. Domine a busca de arquivos no Linux com o comando find!
Você já se perguntou como os especialistas em Linux conseguem encontrar arquivos em um emaranhado de diretórios? Saiba que há um comando mágico chamado find que lhes concede esse poder.
Maximize o desempenho do seu banco de dados com a ferramenta pg_activity
O monitoramento eficaz de um banco de dados é crucial para manter um desempenho otimizado e garantir a disponibilidade contínua de suas aplicações. Neste post, vamos explorar como a ferramenta
ELK Stack vs OpenSearch Stack: Qual escolher?
Ter uma observabilidade completa do seu ambiente com poucas ferramentas, é o sonho de todo profissional DevOps. Diversas ferramentas no mercado atendem essa demanda prometendo entregar apenas uma solução para